PDF Skills 选型:提取、编辑与阅读应该用哪个子 Skill
最后更新:2026-10-26
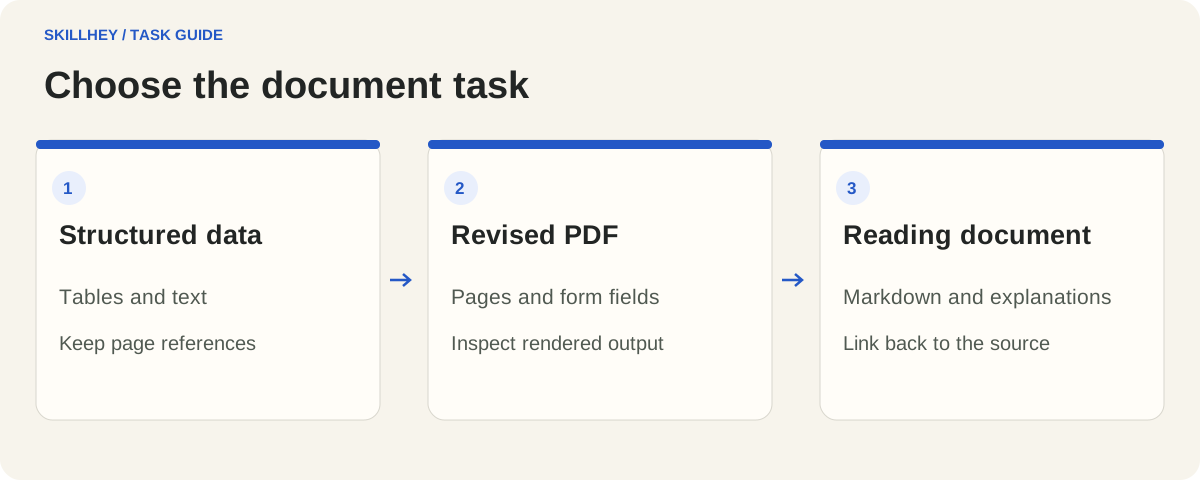
“处理 PDF”还不足以确定任务。从会议日程中提取表格、旋转扫描页面、填写表单和阅读论文,输入都可能是 PDF,最终要交给别人的东西却不同。选 Skill 前先把动词说清楚,后续才容易判断工具是否适合、结果是否完整。
本文比较五个具体子 Skill。推荐卡片直接进入任务详情页,安装前可以查看对应说明与依赖。Anthropic、DeepTutor 和 Learn Claude Code 是其中几个任务所属的项目;合集的名字不能代替实际任务。本组选型依据作者公开工作流,不是统一条件下的速度或识别准确率测试。
PDF 子 Skill 快速选择

PDF Processing
创建与检查 PDF,提取文字和表格,合并页面,并处理表单或扫描文档。
19.3万Stars/plugin marketplace add anthropics/skills
/plugin install document-skills@anthropic-agent-skills安装选项
/plugin marketplace add anthropics/skills/plugin install document-skills@anthropic-agent-skills在 DeepTutor 工作流中读取、提取、制作或编辑 PDF 文件。
5.9万Starspip install -U deeptutorLearn Claude Code Skills: PDF Processing
使用常见 PDF 工具和 Python 库读取、创建、拆分与合并文档。
8万Starsgit clone https://github.com/shareAI-lab/learn-claude-code.git

Nature Reader
生成带来源锚点的中英文对照 Markdown 论文阅读稿,关联正文、图表与公式。
5.3万Starsnpx skills add Yuan1z0825/nature-skills --agent codex --skill nature-reader --skill nature-shared --yes --copy安装选项
npx skills add Yuan1z0825/nature-skills --agent claude-code --skill nature-reader --skill nature-shared --yes --copyAgent 支持情况
由 Skill 作者声明
| Skill | Agent 支持情况 |
|---|---|
| PDF Processing | Claude Code |
| Claude Code, Codex CLI, GitHub Copilot, Hermes Agent, OpenCode, Google Antigravity | |
| Learn Claude Code Skills: PDF Processing | Claude Code |
| Waza Read | 未注明 |
| Nature Reader | Claude Code, Codex CLI, Hermes Agent, OpenCode |
| 当前任务 | 子 Skill | 应交付什么 |
|---|---|---|
| 提取、创建或修改 PDF | PDF Processing | 修改后的文件或提取内容,以及必要的原页核对 |
| 在 DeepTutor 中操作文档 | DeepTutor PDF | 当前操作对应的输出文件 |
| 用简明工具流程完成单项操作 | Learn Claude Code PDF Processing | 有明确范围的提取、转换或页面操作 |
| 把网页或 PDF 变成可读文字 | Waza Read | Markdown、摘要或带出处的摘录 |
| 制作较完整的双语论文阅读材料 | Nature Reader | 与论文内容对齐、可回查来源的 Markdown |
先说明接收者需要什么
同事需要继续计算,就应拿到字段明确的表格;读者需要了解内容,就应拿到带来源的解释;要继续填写的表单,则需要正确字段和保留版面的文件。即使同一个 Agent 能完成这些工作,也应分别约定交付条件。
提取任务要说明页码、字段、顺序和格式。修改任务要列明允许改什么、必须保留什么。阅读任务要说明读者是谁、要回答哪些问题。尤其要区分 PDF 文件中的第几页和页面印刷的页码,避免交付后无法定位。
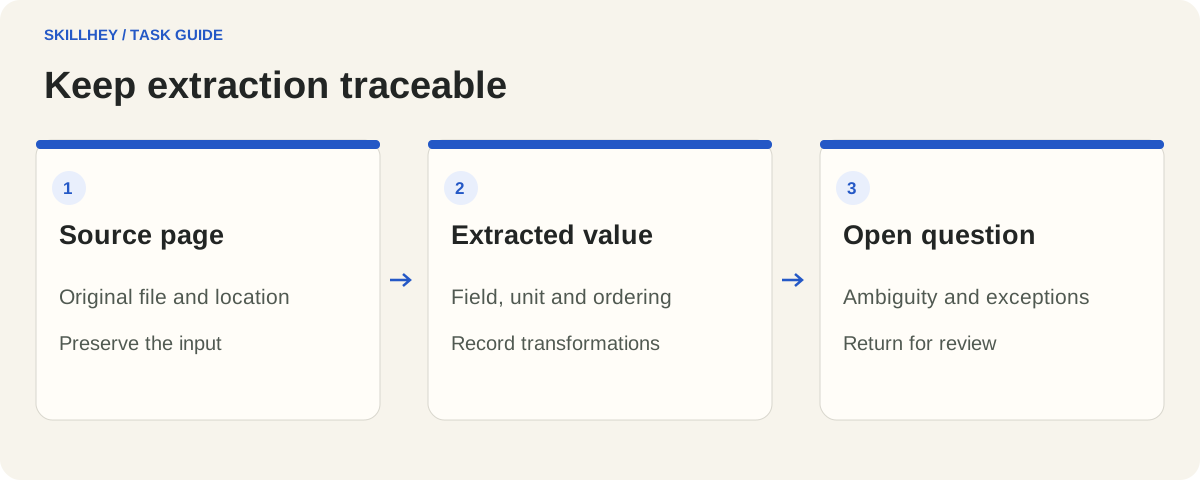
一个可直接调整的需求是:“从这份活动手册第 3–8 页提取活动名称、日期、教室和报名链接,输出 CSV。每条记录保留来源页码,无法确认的行单独列出。”来源和疑问清单能让修正落在具体内容上。
先看原件的结构
先检查有代表性的页面。可选中文字的 PDF 仍可能存在阅读顺序问题;扫描页可能需要 OCR;一份文件还可能混合两种页面。不要用首页提取成功来代替对整份文件的判断。
表格也需要单独检查。视觉上整齐的网格,在文件内部可能是互不关联的文字片段。换行表头、合并单元格、重复标题和脚注,都可能改变提取结果的含义。先处理小样本,确认字段关系,再扩大到整个目录。
保留原件和输出文件的对应关系。文件名、处理范围、采用的方法、输出位置和未解决问题,都值得写进批次清单,方便中断后续接,也便于发现漏页或重复处理。
PDF Processing:通用文档操作
Anthropic PDF Processing 适合提取、页面操作、文档创建和表单处理等任务。官方入口 会按具体操作选择 Python 库或命令行工具。安装 Skill 不等于已经装好全部库和 OCR 依赖。
如果要制作报告,就明确要求可读的表格、合理分页和渲染后的检查;如果是表单,先提供字段与期望值。保留入口引用的支持文件,并查看文档 Skill 自己的许可。公开仓库不代表其中每个组件都可按同一种许可重新分发。
DeepTutor PDF:结合已有工作环境
DeepTutor PDF 涵盖阅读、文字和表格提取、创建、页面操作、表单与页面渲染。它是 DeepTutor 的内置任务,适合已经在这一环境中工作的人。
阅读内置 PDF 说明,确认工作区假设和运行依赖。如果换到其他 Agent 使用,需要先确认如何提供完整任务目录及其工具。每次仍应指定当前要做的那项操作,而不是把支持功能列表直接当作交付要求。
Learn Claude Code PDF:紧凑的工具指南
Learn Claude Code PDF Processing 提供较简短的 PDF 工具与 Python 操作说明,适合边界清楚的提取、创建、拆分或合并任务。
课程里的任务说明 可独立阅读,但克隆课程不等于向所有 Agent 注册了 Skill,课程的可执行示例也有单独依赖。要求 Agent 说明所用工具、输入范围和输出路径,遇到结构不同的 PDF 时会更容易排查。
Waza Read:优先得到可用的阅读内容
Waza Read 面向网页和 PDF 的内容读取,适合需要 Markdown、摘要或带出处摘录的场景。它与重新设计 PDF 版面的任务有不同交付重点。
先说明要忠实提取、压缩总结、回答问题,还是保存到本地。凡是后续需要别人核对的判断,保留链接或页码。Waza 的读取说明 包含获取路线与边界;浏览器能打开某个链接,不代表 Agent 具有同样的会话、订阅或获取能力。
Nature Reader:制作论文阅读材料
Nature Reader 用于生成与原文内容对齐的中英双语 Markdown 阅读材料,涉及正文、图、表和公式。它适合需要反复回看论文的人,交付物比普通摘要更完整。
上游流程 区分完整阅读材料、针对来源的问答和片段翻译。保留引用的支持文件,以及需要时使用的 nature-shared。上游目录将该流程标为 Beta,安排大批量工作前应先查看当前要求。
解释公式时保留符号、定义和条件;讨论图片时指向相应图号;把简化解释和论文原话区分开。这样读者能利用讲解,而不失去返回原文判断的机会。
批量处理时保留清单
先挑选扫描页、多栏正文、大表格或特殊字体等困难样本,确认输出结构和命名。每个文件记录处理范围、方法、产物和疑问,再扩大批次。
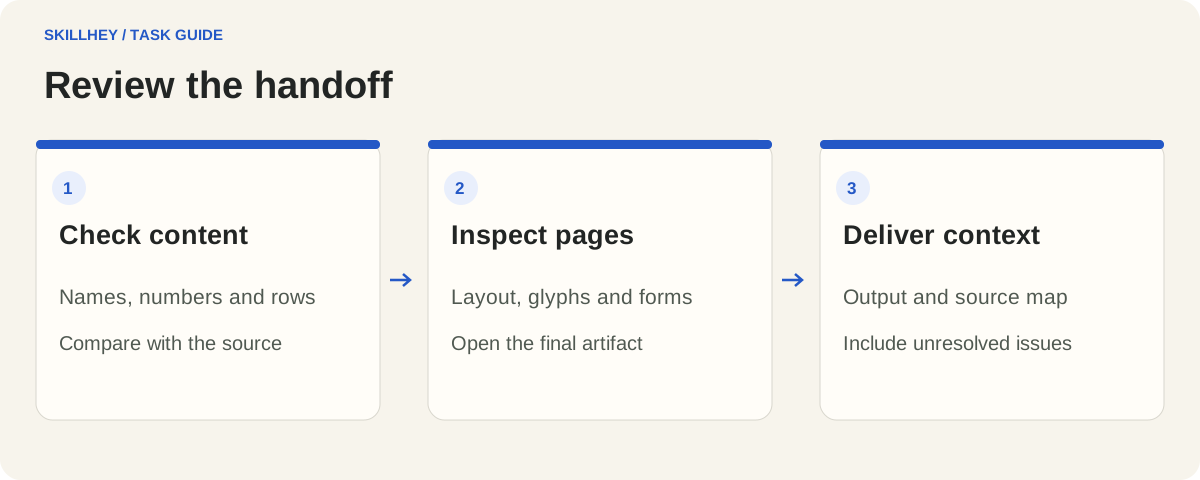
提取事实与编辑解释也应分开。日期看不清就保留待确认状态;总结段落时保留来源;统一日期或单位时说明规则。最终交付请求的文件、来源映射和简短疑问清单,接收者便不用重读整段 Agent 对话。
交付前检查什么
提取结果重点检查漏行、错字、脚注、列对应关系以及重要数字、日期和姓名。对照普通样本,也逐条查看已标记的例外。修改或新建的 PDF 则需要打开渲染页面,检查截断、乱码、空白页和字段位置。
如果别人要继续编辑,明确还需交付哪种源文件。PDF 导出与可编辑工作文档承担不同用途。也要区分安装费用和运行费用:Agent、模型、OCR 服务及其他工具可能各自计费,敏感材料还需要确认具体处理路线是否发送文件到外部服务。
常见问题
第一次使用,应该选哪个 PDF Skill?
通用文件操作可先看 PDF Processing;只想得到可读文字可看 Waza Read;制作完整双语论文材料可看 Nature Reader。已经使用 DeepTutor,或偏好简短工具指南的人,也可以从对应入口开始。
扫描 PDF 能处理吗?
部分流程可以在工具具备时通过 OCR 处理扫描页。OCR 是额外步骤,结果仍要核对。保留原页,标记不确定字符,尤其不要仅凭文字看起来流畅就认定所有数字都正确。
提取文字会保留原版面吗?
取决于输出格式。纯文本、Markdown、电子表格和渲染 PDF 保留的信息不同。表格、公式、栏目或图片位置重要时,要在需求中写明,并用有代表性的页面比较结果。
几个通用 PDF 入口能算独立产品吗?
它们来自不同项目,但方法和底层工具可能重叠。应比较实际说明与运行环境,不能仅凭目录里有多个条目就推断它们使用独立引擎,或已完成准确率对照。
论文摘要可以代替原文吗?
摘要可以帮助导航,重要结论仍要回到方法、结果与限制中检查。要求保留章节或页码,再通过研究类 Skills 继续审查证据。
交给 Agent 的材料应包括什么?
提供原件或可访问链接、页码范围、输出格式、目标读者、重要字段示例、命名要求和疑问记录方式。完成后还要继续写作,可以衔接写作类 Skills。
从上方卡片进入具体子 Skill,阅读当前安装说明,再交给它一个边界明确的文档任务。