人物蒸馏 Skills:把经验整理成 AI 可以复用的工作方法
最后更新:2026-11-03
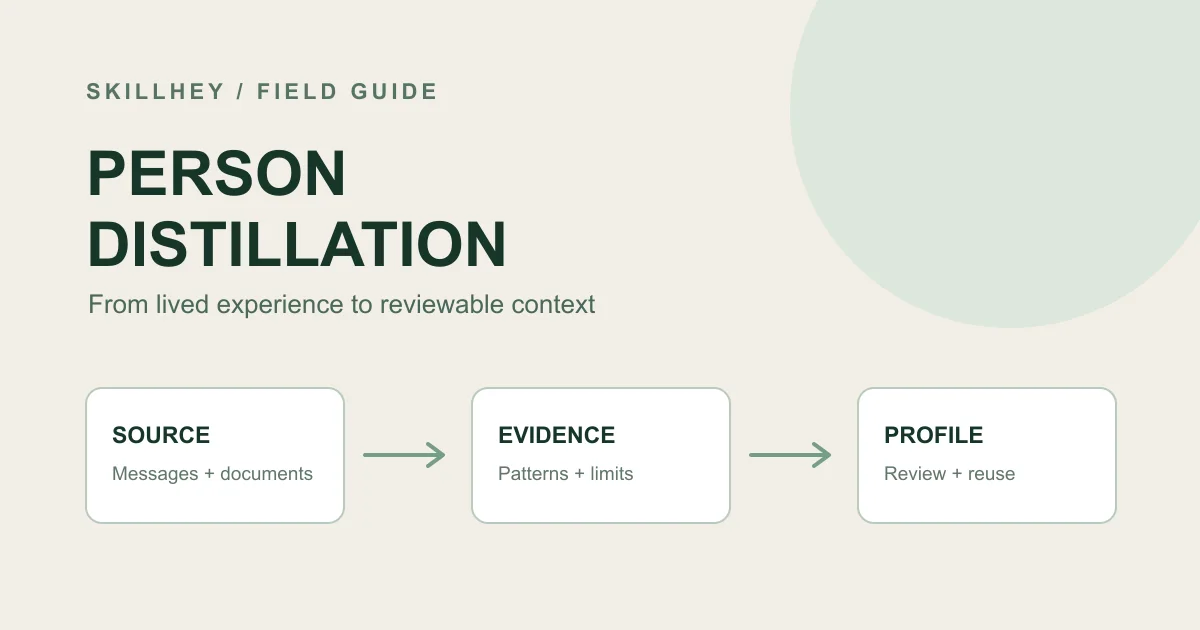
同事离职,几年积累的业务背景也跟着带走;你反复告诉编程 Agent 什么才算“完成”;你读了某位作者的作品,想把其中一个方法用到新问题上。这些场景都指向同一个问题:能不能把已有材料整理好,让 Agent 以后继续使用?
人物蒸馏 Skill 提供了一种做法:从消息、文档、访谈或会话记录中整理一个人的工作方法、判断依据或表达习惯,再生成 Agent 能读取的指令。产物是对已有材料的解释,不能等同于真人。本文按五个项目的公开说明比较;我们没有进行统一的对照测试,也没有测量它们对真人的还原度。
Nuwa Skill
调研人物或主题,将心智模型、决策启发式与表达方式整理成可运行的 Agent Skill,并提供现成的人物视角与主题 Skills。
3.8万Starsnpx skills add alchaincyf/nuwa-skill安装选项
git clone https://github.com/alchaincyf/nuwa-skill.gitImmortal Skill
从消息与文档整理有来源的人物档案,并提供资料使用条款和移交保护流程。
1145Starsgit clone https://github.com/agenmod/immortal-skill.gitEmulo
从 AI 编程会话提取个人工作画像,并提供画像建立、重复指令分析及视频工作流。
305Starsnpx skills add ohad6k/emuloAnyone to Skill
从文档、聊天记录、音频或视频创建人物视角 Skill,并包含预设人物提示。
134Starsnpx skills add OpenDemon/anyone-to-skillAgent 支持情况
由 Skill 作者声明
| Skill | Agent 支持情况 |
|---|---|
| Distilly Person Profiles | 未注明 |
| Nuwa Skill | Claude Code, Codex CLI, Cursor, GitHub Copilot, DeepSeek Harness, Gemini CLI, Grok Build, Hermes Agent, OpenCode, Pi, Kiro, Rovo Dev, Qoder, Mistral Vibe, Google Antigravity |
| Immortal Skill | 未注明 |
| Emulo | 未注明 |
| Anyone to Skill | 未注明 |
完整列表为作者声明,并非测试结果。
| 项目 | 从什么材料开始 | 主要产物 | 适合的起点 |
|---|---|---|---|
| Distilly | 消息、文档、访谈或公开资料 | 有来源依据的人物档案,并打包为 Skill | 整理同事经验或已有记录中的人物视角 |
| 女娲.skill | 人物或主题、公开调研及可选的自备材料 | 包含心智模型、决策方法与表达方式的人物视角 Skill | 调研人物思维,或为问题寻找合适的视角 |
| 永生.skill | 获授权的消息、文档等记录 | 分别记录做事、互动、记忆与价值观的档案 | 整合多来源资料并记录证据冲突 |
| Emulo | 自己与 AI 编程工具的会话 | 个人工作画像及不同任务的上下文 | 找出你反复纠正 Agent 的习惯和要求 |
| Anyone to Skill | 文档、聊天、音频或视频 | 人物视角 Skill 与流水线产物 | 用多种材料尝试创建人物视角 |
它们的名字相似,但输入和审阅重点不同。先确定手头是什么材料、准备解决什么问题,再选择工具。
这里的“蒸馏”是什么意思?
这些项目主要把信息整理成 Agent 可读取的文件和指令,并不一定训练小模型或改变模型参数。例如,一份画像可能记录:某人在接受故障修复前,经常要求先复现问题;再附上支持这个判断的记录,以及它适用的场景。以后 Agent 执行相关任务时,就可以读取这条指令。
有用的画像需要区分观察和推断。如果记录确实支持,“三次发布前都要求线上检查”是观察;“这个人从不信任任何人”则是宽泛得多的解释。生成内容说话流畅,也不代表它提炼出的规则准确。
Distilly:整理有记录可查的经验和判断
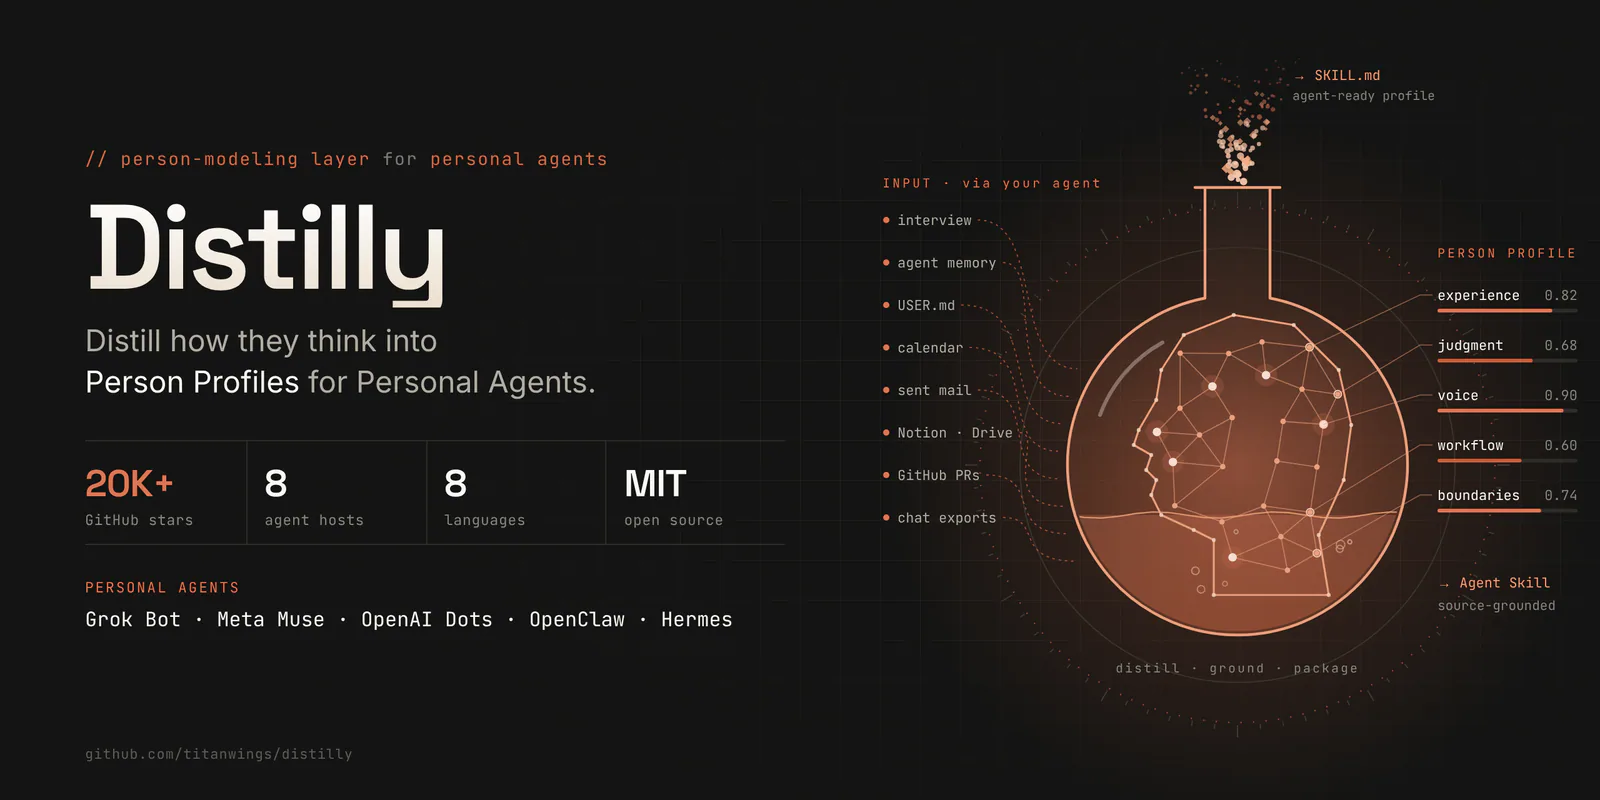
Distilly 原名同事.skill。它根据用户提供的材料创建人物档案;当前仓库描述的对象已经不限于同事,也包括关系人物和公众人物等,并将档案打包为 Agent Skill。对于获得授权的工作交接,可以先用它整理某个人处理重复问题的方法。
给 Agent 一个具体任务,例如“整理工程师如何排查线上故障”,并提供获准使用的故障复盘和决策记录。要求列出证据、时间、缺失信息和不同说法。少量消息不足以证明一个人在所有场景下都会这样做;系统变化后,旧判断也可能不再适用。
女娲.skill:调研并提炼人物的思维方式
女娲.skill 根据指定的人物或主题生成人物视角 Skill。项目指引描述了调研资料、提炼心智模型与决策启发式、组装可运行 Skill 的流程。如果只有问题、还不知道该参考谁,它也可以先推荐值得调研的视角。用户可以提供自己的原始材料,仓库也附有现成示例。
开始前应确定调研范围和预算:指引提供快速、标准和深度档位,实际成本取决于模型和工作量。使用前检查来源与生成的判断;人物视角是对已有材料的解释,不代表本人背书,也不是本人真实发言。我们检查了公开指引,尚未完成完整蒸馏。
永生.skill:分维度整理,并保留矛盾
永生.skill 将档案拆成做事知识、互动方式、记忆经历以及人格或价值观。根流程描述了角色模板、资料采集、证据分级、冲突处理和 Skill 目录生成;具体平台能否接入,取决于相应工具和凭证。
同一仓库还提供蒸馏协议,用于生成资料使用条款和清单;以及防蒸馏,用于生成金丝雀标记等可选移交保护措施。条款模板不能替代法律意见,标记也无法保证资料不会被再次使用。第一次尝试,建议选择一小批获授权的材料,不必先采集所有聊天记录。
Emulo:从自己的 Agent 会话中找习惯
Emulo 解决的问题更窄:你反复要求编程 Agent 做什么?它从受支持的本地会话中提取用户自己写的消息,并可生成带日期证据的工作画像。Session Coach 可以先在本地生成无需模型调用的重复消息报告,帮助判断是否值得继续建画像。
项目的蒸馏流程会先展示预检计划,模型调用前需要确认。提取和存储可以在本地进行;如果选择云端模型,选中的证据仍会发送给相应服务商。画像也可能包含原话,写入共享项目文件之前要检查目标位置。
Emulo 的公开测试说明区分了“画像改变输出”和“工作质量提高”。作者报告的与虚构画像对照结果并不一致,也没有声称测试已经证明工作变好。不同宿主如何加载画像也不同,安装后应按当前说明确认 Agent 是否真的读取。
Anyone to Skill:从不同材料创建人物视角
Anyone to Skill 描述了两种模式:使用预设人物对话,以及根据材料创建新人物。Skill 指引描述了材料接入、特征提取、综合、Skill 组装和 QA 报告。音频转录及其他格式需要各自的依赖,Python 流水线还需要模型配置。
预设人物只是简短指令,生成的回答不能当作公众人物真实发表的观点,也不能作为投资、职业或医疗建议。创建新画像时,分享前应检查处理后的语料、生成判断和文件。我们检查了任务入口;本地运行命令行帮助时缺少 openai Python 依赖,尚未完成完整蒸馏。
先做一个小实验
选择一个具体任务和少量有权使用的记录,例如:
为我创建一份“如何审查产品需求”的画像初稿。
只使用我提供的三份文档。每条规则列出来源,并区分直接证据和推断。
保留互相矛盾的记录与资料缺口;不要编造引文、私人观点或承诺。
最后列出需要我本人检查的部分。
然后拿一份此前没有提供的新案例,让画像说明适用哪条规则、为什么,并对照原始材料;条件允许时,也请本人判断。一个案例答对只能说明通过了这一项检查,不能直接推算整体还原度。没有依据或概括过头的规则,应修改或删除。
使用他人的消息前,先确认授权范围和接收对象;移除与任务无关的个人信息,检查材料在哪里处理,并在分享前检查生成的每个文件。自动脱敏和提示词保护都不能保证绝对保密。
常见问题
人物 Skill 等于训练了一个模型吗?
不一定。这里的项目主要生成供 Agent 读取的文件和指令,模型本身以及服务商如何处理数据是另外的问题。
Skill 能预测某个人会说什么吗?
它能根据指令和模型生成回答。这个回答是一种假设或模拟,不能当作本人真实的发言或决定。
应该先试哪一个?
想了解自己与编程 Agent 的重复沟通,可以先看 Emulo 的报告;整理同事已有工作经验,可以考虑 Distilly 或永生.skill;调研人物思维视角可以考虑女娲.skill;希望尝试多种材料,可以先检查 Anyone to Skill 的依赖。
本地采集就意味着全程隐私安全吗?
不能这样推断。需要分别检查模型服务商、脚本、生成文件和保存位置。本地采集之后仍可能调用云端模型,或把原话写入共享项目。