关于这个 Skill
对 PDF、扫描件和 Office 文档执行 OCR、结构化提取,并保留页码或区块引用。
为什么推荐
聚焦单一任务的上游工作流,下方保留原始安装说明和任务入口。
使用前需要了解
- 需要 MinerU 4.x 和 Python 3.10–3.14;模型下载、硬件与可选服务取决于所用后端。
支持的 Agent
Cursor
资料与来源
原始资料见下方链接;文中的上手建议由 SkillHey 编辑整理。
对 PDF、扫描件和 Office 文档执行 OCR、结构化提取,并保留页码或区块引用。
聚焦单一任务的上游工作流,下方保留原始安装说明和任务入口。
原始资料见下方链接;文中的上手建议由 SkillHey 编辑整理。

借助 MinerU 将 PDF、扫描件和 Office 文件解析为 Markdown,支持 OCR、公式表格提取、批量处理及可选本地解析。
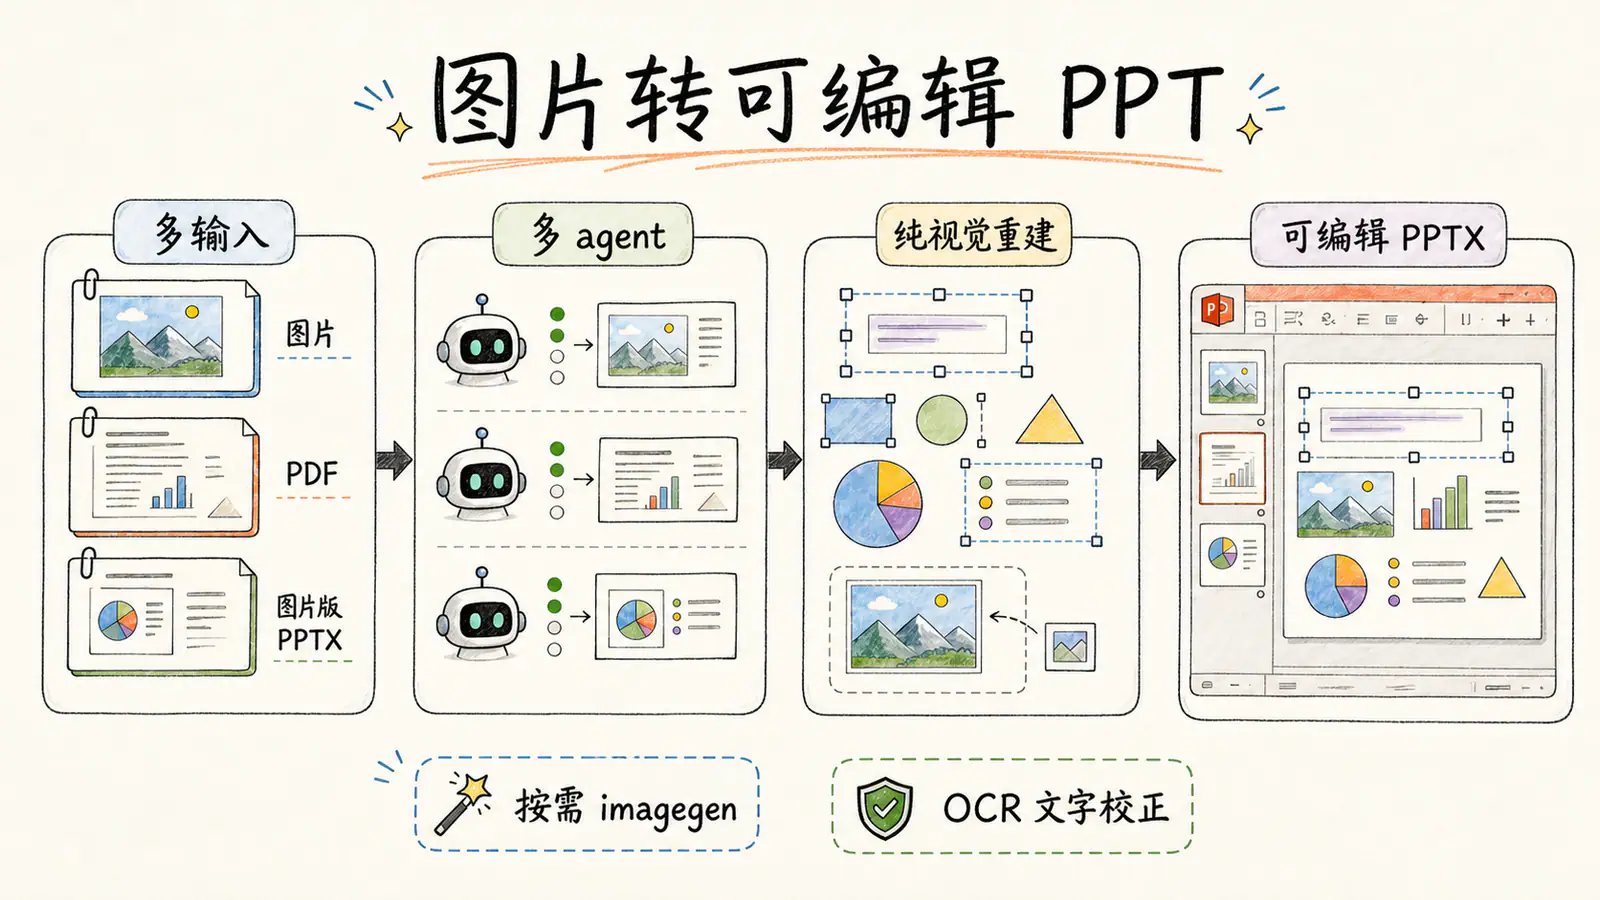
将幻灯片图片、扫描 PDF 和图片版 PPTX 重建为可编辑的 PowerPoint 文字、表格与形状,保留独立视觉素材并校验产物。