Free
Research & data
BOSS Zhipin Job Research
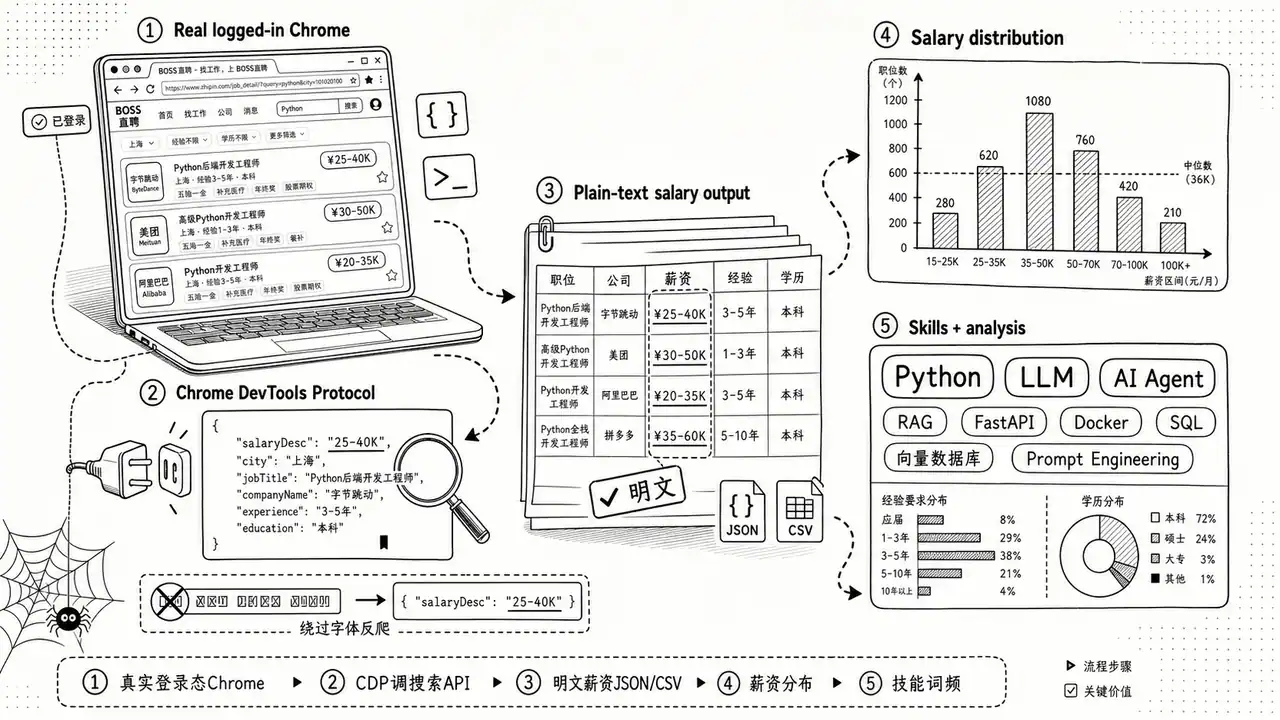
Collect job listings and descriptions from BOSS Zhipin through Chrome CDP and organize the results as JSON, CSV, or a job research report.
1.7KStars228Forks
Repository last pushed
eatmoreduck
These skills help an agent retrieve pages and turn web material into structured notes or records. They cover Apify, Reddit, Google Maps, job boards, Defuddle, and browser-based extraction.
11 skillsCollect job listings and descriptions from BOSS Zhipin through Chrome CDP and organize the results as JSON, CSV, or a job research report.
Retrieve Reddit posts and discussions using a browser-backed JSON access workflow.
Run the local Google Maps scraper to collect business listings, reviews, and available contact details.
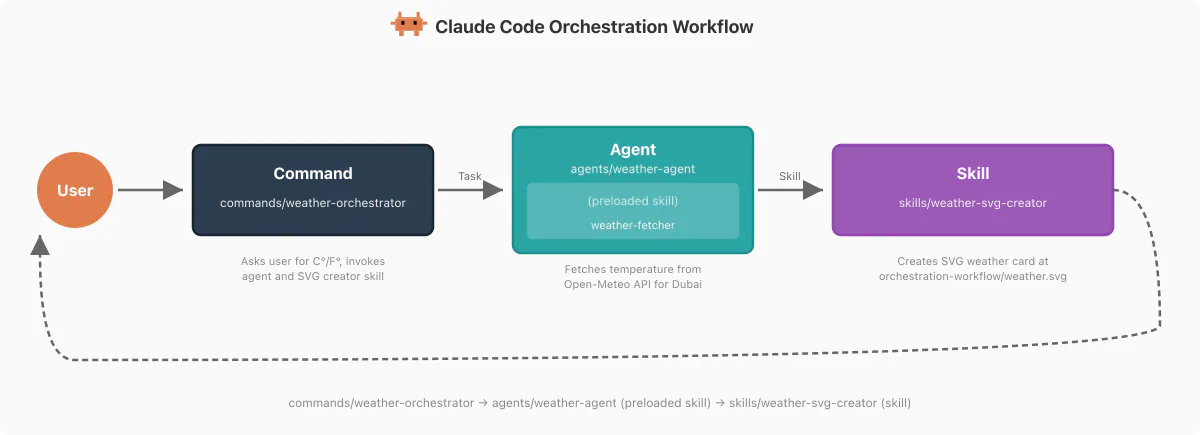
Fetch current Dubai temperature data from the example’s Open-Meteo endpoint.
Turn a business category and location into a structured CSV of local businesses using a locally hosted Google Maps scraping engine.
Use an Apify actor as a configured job-source provider in the CareerOps pipeline.
Extract clean Markdown from HTML pages with Defuddle CLI.
Summarize or extract text/transcripts from URLs, podcasts, and local files (great fallback for “transcribe this YouTube/video”).
Use a browser retrieval skill when pages need interaction, a source-specific scraper for maps or jobs, and a parser such as Defuddle when the page is mainly text.